Шаг 11. Локальные модели
В главе про безопасность могло показаться, что я нагнетаю и что эти ограничения вообще сужают круг задач до минимума. Ведь когда дело доходит до персональных данных, то тут вообще туши свет. Даже случайная отправка считается нарушением и карается.
При этом нужно разграничивать просто обработку данных и трансграничную передачу данных. А использование западных сервисов автоматически подразумевает именно этот вариант.
Так что же, получается, если есть необходимость обрабатывать коммерческую тайну или персональные данные, выхода совсем нет?
Не все так плохо, безусловно, выход есть. Многие достаточно мощные модели можно скачать и использовать локально в замкнутой среде без отправки данных в сторонние сервисы. Проблема только в том, что для более или менее мощной модели нужны дорогие видеокарты, которые справляются с вычислениями лучше, чем процессор.
На личном Ryzen 7 с 64 Гб памяти и видеокартой RTX 3060 с 12Gb памяти локально можно запустить только модели уровня gpt-3.5. Я пробовал мучать модели Qwen 2.5 и подобные. Работает, но крайне медленно с намерением упасть при попытке загрузить большой контекст. Поэтому, когда я говорю "дорогие видеокарты", речь не про игровую RTX за 50 тысяч. Для нормальной работы с LLM нужна карта с 48 ГБ памяти — это уже от 250 тысяч рублей за штуку. А если нужно запустить что-то сопоставимое с GPT-4.1, надо готовить от полумиллиона только на железо.
Плюс энергия. Если GPT-5 через API стоит условные 120 рублей за миллион токенов, то собственный сервер окупится только при постоянной и очень большой нагрузке.
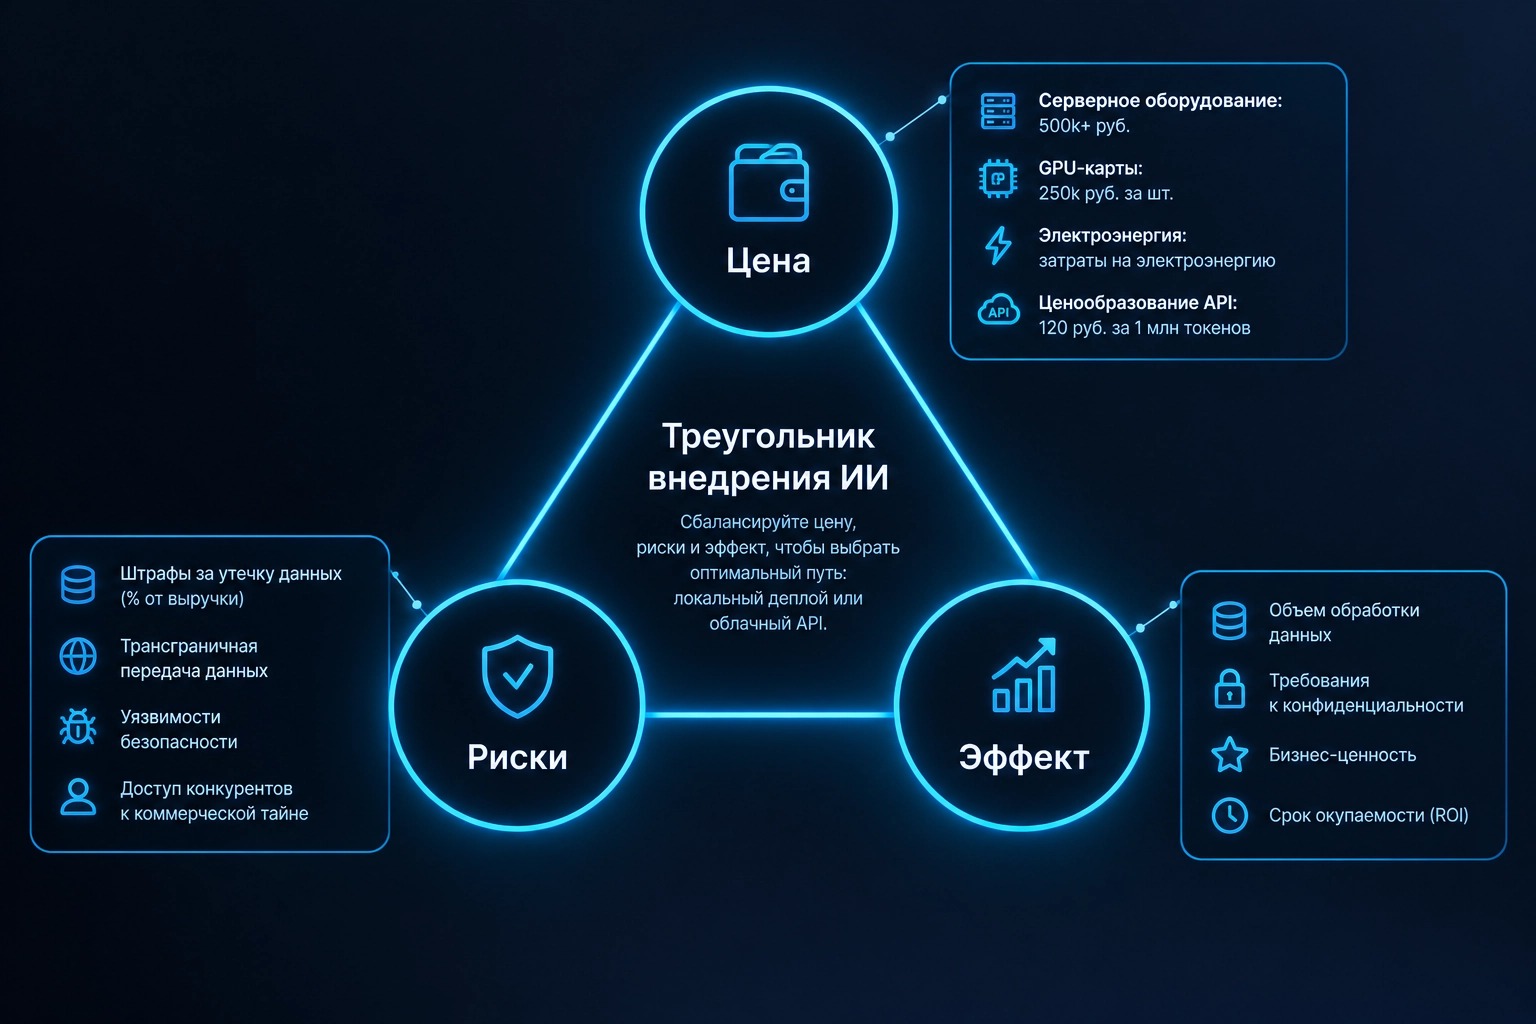
Тут нужно оценивать — может, проще платить за API и просто не отправлять туда чувствительные данные.
Что можно запустить локально?
Задачи транскрибации (Whisper) и генерации текста хоть и медленно, но можно даже решить без графической карты на мощном компьютере, а вот для генерации изображений и полноценных LLM моделей без них не обойтись.
Конкретно для задач уровня "саммаризация документов" или "классификация текстов" хватит моделей типа Llama 3.1 8B — её можно крутить даже на хорошем ноутбуке. Для полноценного помощника нужны модели от 70B параметров — тут уже серверное железо с несколькими видеокартами.
Есть промежуточный вариант — российские облачные провайдеры с API к локальным моделям. Yandex GPT, GigaChat, несколько меньших игроков. Данные остаются в России, формально не уходят за границу, но всё равно покидают ваш периметр.
Для задач, где важна именно неразглашение конкурентам и партнерам, но не критична трансграничная передача, это рабочий вариант. Дешевле собственного сервера, быстрее CPU, юридически чище западных API.
Но если данные вообще нельзя выпускать из контура — только своё железо.
Как развернуть
В рамках этой книги я не предполагаю давать алгоритм по развертыванию, тем более что теперь вы знаете, как создать ассистента, который подскажет, как сделать, или агента, который это может сделать сам 😀
Сценарий такой: снимается сервер, даем агенту доступ, он всё настраивает — находит инструкции, устанавливает нужные пакеты, разворачивает модель. Потом агента убираем, внешний интернет отрубаем, или оставляем только входящие соединения — и работа далее ведется в замкнутом контуре.
Звучит параноидально, но для работы с реальными персональными данными или коммерческой тайной это единственный способ спать спокойно.
Локальная модель оправдана, если:
- обрабатка персональные данные в больших объёмах;
- работа автоматизируется с коммерческой тайной, которую нельзя выпускать из периметра;
- есть постоянный поток задач, который окупит железо и электричество;
- есть специалист, который может настроить, поддерживать и обновлять систему.
Для разовых экспериментов, небольших проектов или задач без чувствительных данных проще использовать API. Но если масштаб растёт, а требования к конфиденциальности жёсткие — локальная модель может стать необходимостью. Но тщательный просчет экономики этого предприятия просто необходим, т.к. это не та история, что "агент за 100 рублей мне накатал сервис". Тут итоговая цена может оказаться такой, что весь выигрыш от использования ИИ становится отрицательным.